

 News
 Coin Information
 About us


 Add as a preferred source on Google
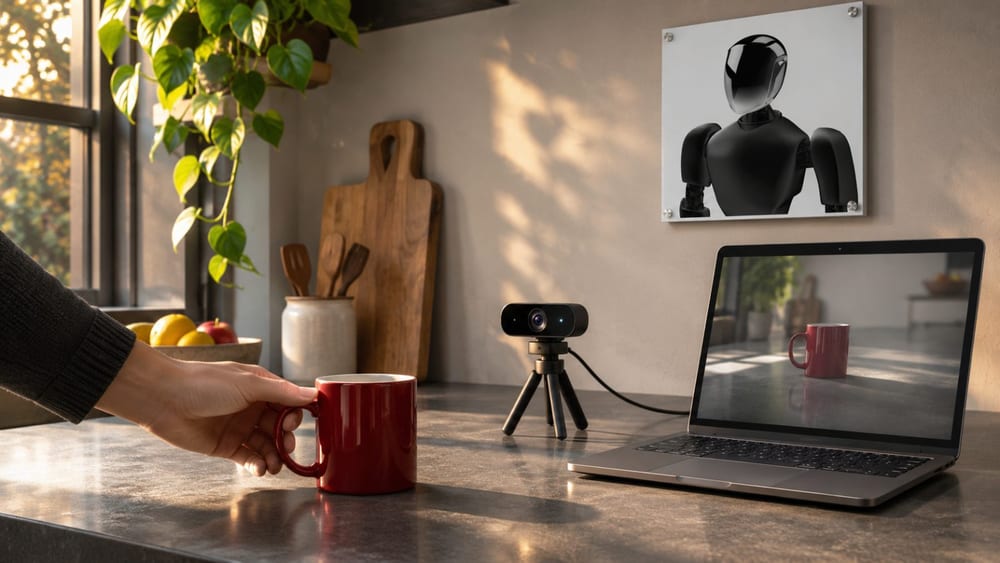
เปิดตัว ALIVE โมเดลภาษาสำหรับวิดีโอแบบเรียลไทม์ที่จัดการคำขอจากผู้ใช้หลายรายการ และถามข้อมูลเพิ่มเติมเมื่อหลักฐานในวิดีโอยังไม่เพียงพอ ระบบยังออกแบบให้แจ้งเตือนเมื่อพบเงื่อนไขที่ผู้ใช้กำหนด โดยไม่ต้องรอให้ผู้ใช้ถาม
คณะนักวิจัยจากมหาวิทยาลัยชิงหัว (Tsinghua University) มหาวิทยาลัยปักกิ่ง (Peking University) และไบต์แดนซ์ (ByteDance) นำเสนอ ALIVE ในบทความบน arXiv ซึ่งเผยแพร่เมื่อวันที่ 16 พ.ย. เวลา 23:35 น. ตามเวลาไทย งานวิจัยนี้มุ่งพัฒนาเทคโนโลยีที่รับชมวิดีโอขาเข้าและตัดสินใจว่าจะตอบเมื่อใด ไม่ใช่เทคโนโลยีสร้างวิดีโอ
บทความระบุว่าโมเดลวิดีโอสตรีมมิงแบบเดิมมักตอบคำถามแต่ละข้อแยกกัน แม้จะเฝ้าดูกระแสวิดีโอต่อเนื่อง ส่วน ALIVE ออกแบบให้เก็บคำขอของผู้ใช้ไว้เป็นงานที่กำลังดำเนินอยู่ แทนที่จะจัดการเป็นคำถามครั้งเดียว
ผู้ใช้สามารถสั่งให้ระบบเฝ้าดูฉากหรือเงื่อนไขบางอย่างได้ หากมีคำสั่งใหม่ ผู้ใช้สามารถปรับหรือยกเลิกงานที่กำลังดำเนินอยู่ และระบบออกแบบมาให้จัดการคำขอหลายรายการพร้อมกัน
โมเดลประเมินว่ามีหลักฐานจากวิดีโอเพียงพอสำหรับตอบหรือยัง ก่อนตัดสินใจว่าจะตอบเมื่อใด หากข้อมูลยังไม่พอ ระบบอาจถามคำถามเพิ่มเติม ขอให้ผู้ใช้แสดงข้อมูลที่จำเป็นบนหน้าจอ หรือพักการตอบไว้จนกว่าจะมีหลักฐานรองรับ
โมเดลพื้นฐานของ ALIVE คือ Qwen3-VL-8B-Instruct นักวิจัยฝึกโมเดลเป็นสองขั้น โดยใช้การปรับแต่งแบบมีผู้สอนเชิงเปรียบเทียบ ตามด้วยการเรียนรู้แบบเสริมกำลัง
ขั้นแรกฝึกให้โมเดลตัดสินใจว่าจะตอบหรือรอ และควรตอบในรูปแบบใด โดยใช้ตัวอย่างปฏิสัมพันธ์ 288,436 รายการในการปรับแต่งแบบมีผู้สอน
ขั้นที่สองปรับปรุงการตัดสินใจและคำตอบผ่านบทสนทนาที่ดำเนินต่อเนื่องหลายรอบ โดยใช้ตัวอย่างปฏิสัมพันธ์ 3,523 รายการในการเรียนรู้แบบเสริมกำลัง
ระหว่างจัดทำข้อมูลฝึก นักวิจัยยังใช้โมเดลมัลติโมดัลแบบออฟไลน์แยกต่างหาก เพื่อระบุช่วงเวลาในวิดีโอที่เป็นหลักฐานรองรับคำตอบ สร้างบทสนทนา และตรวจสอบคุณภาพข้อมูล
นักวิจัยรายงานว่า ALIVE ได้คะแนนรวมสูงสุดในบรรดาโมเดลที่นำมาเปรียบเทียบในเบนช์มาร์กสาธารณะ 4 รายการ ได้แก่ OVO-Bench 68.9%, StreamingBench 76.0%, IPIBench 40.3% และ ProactiveVideoQA 51.6
สามคะแนนแรกเป็นค่าความแม่นยำ ส่วนคะแนน ProactiveVideoQA ใช้ตัวชี้วัด PAUC จึงไม่ควรนำขนาดตัวเลขมาเปรียบเทียบกันโดยตรง
เพื่อประเมินความสามารถในการถามข้อมูลเพิ่มโดยเฉพาะ นักวิจัยสร้าง FSI-Bench ขึ้นเอง โดยประเมิน 1,235 เอพิโซด แบ่งเป็นข้อเสนอให้เฝ้าติดตาม 154 รายการ คำขอข้อมูลเพิ่มเติม 446 รายการ คำขอให้ผู้ใช้ดำเนินการ 459 รายการ และคำตอบทันที 176 รายการ
บน FSI-Bench นักวิจัยรายงานความแม่นยำรวมของ ALIVE ที่ 52.8% ในรูปแบบเลือกคำตอบอย่างชัดเจน และ 54.0% ในรูปแบบตอบอย่างอิสระ ส่วนคะแนนอ้างอิงของมนุษย์สำหรับรูปแบบตอบอย่างอิสระที่บทความระบุคือ 88.5%
FSI-Bench เป็นชุดประเมินที่นักวิจัยสร้างขึ้นเอง และใช้โมเดลภาษาขนาดใหญ่ที่กำหนดไว้ตายตัวเป็นผู้ตัดสินความถูกต้องของคำตอบ การอ่านผลประเมินนี้จึงควรพิจารณาทั้งชุดข้อมูลและวิธีตัดสินผลประกอบกัน
ผลของโมเดลเปรียบเทียบบางตัวไม่มีอยู่ในเบนช์มาร์กสาธารณะบางรายการ บทความระบุว่านักวิจัยปรับโมเดลที่ไม่มีผลอย่างเป็นทางการให้เข้ากับโค้ดประเมิน แต่ไม่ได้แสดงข้อมูลที่ทำซ้ำผลการทดลองของทีมวิจัยได้อย่างเป็นอิสระ
ทีมพัฒนาเผยแพร่คลังโค้ดบน GitHub และเช็กพอยต์ ALIVE-8B แล้ว โดยข้อมูลฝึกและ FSI-Bench ยังระบุว่าเตรียมเปิดให้ใช้งานในภายหลัง เดโมเสียงที่ทำงานบนเครื่องต้องใช้ Linux, Python 3.12 และ GPU 2 ตัว ส่วนการรู้จำและสังเคราะห์เสียงใช้โมเดลแยกต่างหาก

Comment 0