

 News
 Coin Information
 About us


 Add as a preferred source on Google
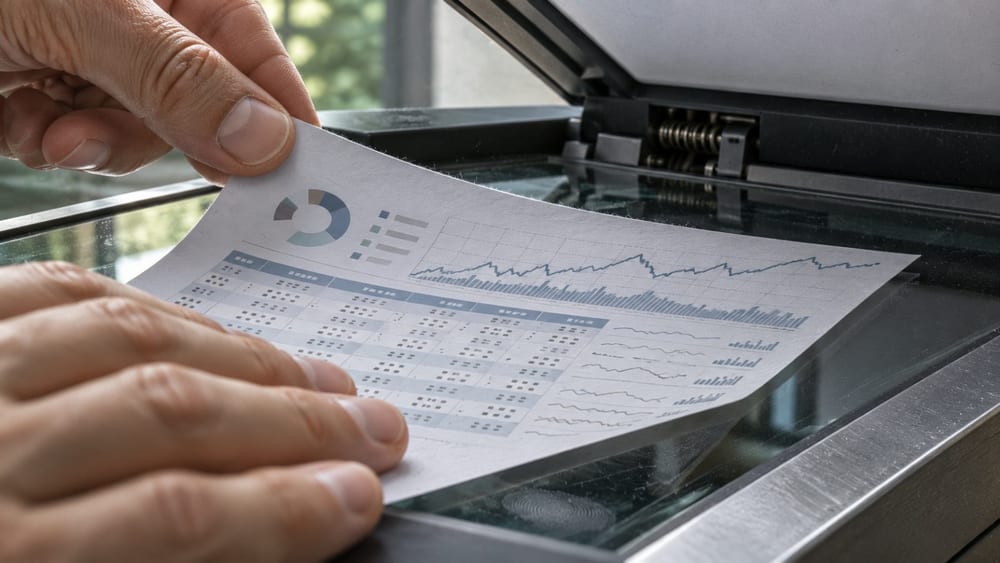
Unsiloed AI ระดมทุนรอบ Seed ได้ 7.5 ล้านดอลลาร์ (ประมาณ 10,000 ล้านวอน) โดยพัฒนาเทคโนโลยีแปลงเอกสารองค์กรให้เป็นข้อมูลที่ AI agent นำไปประมวลผลได้
Felicis (เฟลิซิส) เป็นผู้นำการลงทุนครั้งนี้ โดยมี Y Combinator, Orange Collective, Uncorrelated Ventures และนักลงทุนรายบุคคลเข้าร่วม TechCrunch (เทคครันช์) รายงานเรื่องการระดมทุน ผลิตภัณฑ์ และกรณีใช้งานของบริษัทเมื่อวันที่ 18
Unsiloed AI วิเคราะห์ตาราง แผนภูมิ และรูปแบบการจัดวางเอกสารที่ซับซ้อนในไฟล์อย่าง PDF ก่อนจัดโครงสร้างเนื้อหา การแยกวิเคราะห์เอกสารครอบคลุมทั้งการอ่านตัวอักษร โครงสร้างตาราง และตำแหน่งของข้อมูล แล้วแปลงให้อยู่ในรูปแบบที่เครื่องประมวลผลได้
บริษัทระบุในคำอธิบายผลิตภัณฑ์ว่า ระบบยังบันทึกตำแหน่งของคำที่ดึงออกมาในเอกสารต้นฉบับด้วย ผู้ใช้จึงตรวจสอบได้ว่าเนื้อหาแต่ละส่วนมาจากตำแหน่งใด
อามาน มิศรา (Aman Mishra) ผู้ร่วมก่อตั้งและ CEO ของ Unsiloed AI กล่าวในการสัมภาษณ์ว่า “โดยพื้นฐานแล้ว LLM มีลักษณะเป็นความน่าจะเป็น จึงอาจให้ผลลัพธ์ที่แปรผันและเกิดภาพหลอนได้ ซึ่งส่งผลกระทบเชิงลบอย่างมากต่องานขั้นต่อไป” เขาอธิบายว่าการอ่านตัวเลขในเอกสารการเงินหรือข้อสัญญาในเอกสารกฎหมายผิดพลาด อาจทำให้งานที่ตามมาเกิดข้อผิดพลาดต่อเนื่อง
มิศรากล่าวว่าบริษัททำงานร่วมกับลูกค้าในภาคการเงิน กฎหมาย และการแพทย์ เขายังระบุว่ามีธนาคารและสำนักงานกฎหมายที่ใช้ผลิตภัณฑ์ แต่ไม่ได้เปิดเผยชื่อลูกค้า
ธนาคารแห่งหนึ่งใช้ผลิตภัณฑ์เพื่อประมวลผลเอกสาร ส่วนสำนักงานกฎหมายแห่งหนึ่งใช้จัดการสัญญาและแฟ้มคดีเก่า บริษัทไม่ได้เปิดเผยขอบเขตการใช้งานหรือปริมาณการประมวลผลของลูกค้าแต่ละราย
Bolna AI ซึ่งเป็นบริษัทด้าน AI เสียง ก็ใช้ผลิตภัณฑ์ของ Unsiloed AI เพื่อสร้างฐานความรู้สำหรับ voice agent กรณีนี้เป็นตัวอย่างการนำเอกสารองค์กรมาเตรียมเป็นข้อมูลอ้างอิงให้ voice agent
ตลาดประมวลผลเอกสารยังมีผู้เชี่ยวชาญเฉพาะทางอย่าง Reducto และ Unstructured ขณะที่ไมโครซอฟท์(MSFT) และอะเมซอน(AMZN) ก็มีผลิตภัณฑ์ที่เกี่ยวข้องเช่นกัน
ตัวเลขด้านประสิทธิภาพควรแยกจากผลการตรวจสอบโดยอิสระ เอกสารทางเทคนิคที่ Unsiloed AI เผยแพร่ระบุว่า บริษัทดึงข้อมูลประมาณ 84,000 รายการจากเอกสารการเงินของลูกค้าองค์กร 542 ฉบับ และได้ความแม่นยำ 99.78%
TechCrunch รายงานว่าผลลัพธ์ดังกล่าวยังไม่ได้รับการตรวจสอบโดยหน่วยงานอิสระ ดังนั้นตัวเลข 99.78% จึงควรเข้าใจว่าเป็นผลการทดสอบที่บริษัทเปิดเผย
เอกสารเปรียบเทียบ olmOCR-Bench ที่บริษัทเผยแพร่ระบุคะแนน 88.0 โดยบริษัทเปิดเผยผลและโค้ดสำหรับทำซ้ำไว้ในคลังสาธารณะ อย่างไรก็ตาม ตัวเลขนี้ใช้วิธีวัดและชุดเอกสารต่างจากการทดสอบความแม่นยำบนเอกสารการเงิน จึงนำมาเปรียบเทียบกันโดยตรงไม่ได้
ข้อมูลจำนวนสมาชิกทีมที่เผยแพร่ก็แตกต่างกันเช่นกัน TechCrunch ระบุว่ามี 7 คน ขณะที่หน้าโปรไฟล์บริษัทสาธารณะของ Y Combinator แสดงขนาดทีม 2 คน โดยยังไม่ทราบช่วงเวลาที่ใช้รวบรวมตัวเลขทั้งสองชุด
ในการสัมภาษณ์เมื่อวันที่ 18 มิศรากล่าวว่า บริษัทวางแผนนำเงินทุนไปใช้จ้างนักวิจัยและวิศวกร ขยายงานขาย และพัฒนาชุดข้อมูลของบริษัทเอง

Comment 0