

 News
 Coin Information
 About us


 Add as a preferred source on Google
เคต (Kate) วิศวกรดัดแปลงการ์ดกราฟิก CMP 170HX สำหรับขุดเหมืองของเอ็นวิเดีย($NVDA) จนเพิ่มหน่วยความจำที่ใช้งานได้จาก 8GB เป็น 80GB โดยการทดสอบคำนวณ FP16 ของเธอพบว่าการ์ดที่ดัดแปลงทำปริมาณงานได้สูงกว่า A100 รุ่นปกติราว 18%
เคตระบุในบทความทางเทคนิคที่เผยแพร่เมื่อวันที่ 10 ว่า “ฉันเปลี่ยนการ์ด CMP 170HX 8GB ของฉันให้แทบจะกลายเป็น A100-80G” ชื่อผลิตภัณฑ์ไม่ได้เปลี่ยนเป็น A100 แต่หมายถึงการปลดล็อกหน่วยความจำและความสามารถในการคำนวณที่ถูกจำกัดไว้
CMP 170HX และ A100 ใช้ชิป GA100 รุ่นเดียวกัน เคตอธิบายว่า CMP 170HX รุ่น 8GB สำหรับขุดเหมืองถูกจำกัดหน่วยความจำส่วนใหญ่และความสามารถในการคำนวณบางส่วนด้วยการตั้งค่าฟิวส์อิเล็กทรอนิกส์ (eFuse)
การตรวจสอบการ์ดรุ่น 8GB ของเคตพบว่ามีหน่วยความจำแบนด์วิดท์สูง (HBM) ติดตั้งอยู่จริงราว 80GB ก่อนหน้านี้ วิธีแก้ด้วยซอฟต์แวร์อย่างเดียวทำให้ใช้งานได้สูงสุด 64GB
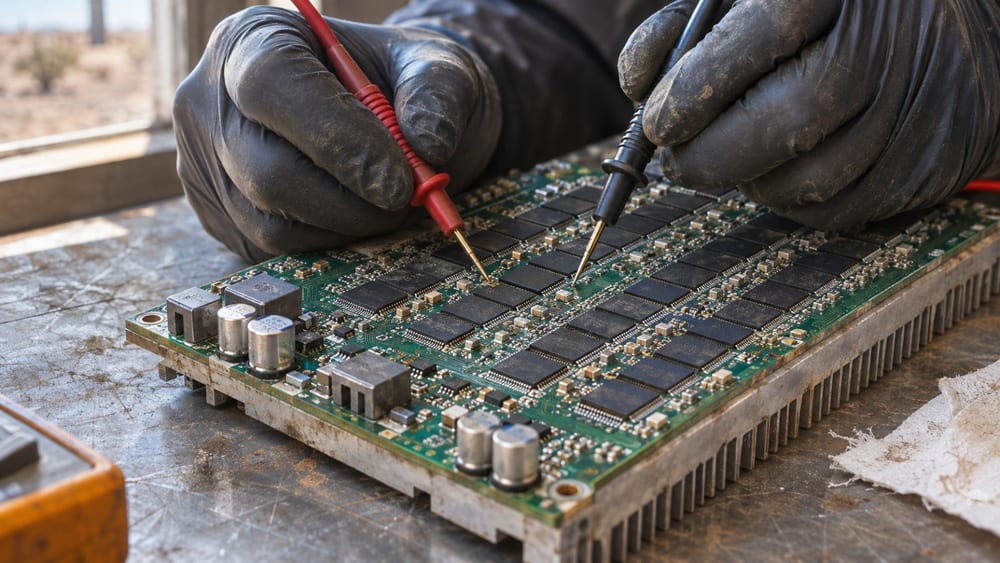
การดัดแปลงครั้งนี้ใช้วิธี “การรบกวนแรงดันไฟฟ้า” (voltage glitching) โดยลดแรงดันไฟฟ้าของชิปลงชั่วขณะ เพื่อเข้าถึงฟังก์ชันควบคุม eFuse ที่ปกติไม่อนุญาตให้เขียนข้อมูล จากนั้นจึงเปลี่ยนการตั้งค่าฟิวส์และการกำหนดค่าซอฟต์แวร์เพื่อปลดล็อกหน่วยความจำและหน่วยประมวลผล
เคตใช้แผงควบคุมขนาดเล็กดักสัญญาณระหว่าง GPU กับตัวควบคุมแรงดันไฟฟ้า แล้วส่งรูปคลื่นสัญญาณอีกชุดเข้าไปเพื่อปรับแรงดัน เธอตัดและต่อไฟการ์ดซ้ำหลายครั้ง และระบุว่าการปลดล็อกฟังก์ชันที่ถูกจำกัดของการ์ดหนึ่งใบใช้เวลา 1–48 ชั่วโมงบนอุปกรณ์ของเธอ
ในบรรดาการ์ด CMP 170HX 8GB จำนวน 10 ใบที่เคตตรวจสอบ มี 9 ใบที่ใช้งานหน่วยความจำได้ 80GB ส่วนอีกใบมีหน่วยความจำที่ทำงานได้ตามปกติ 64GB จึงเพิ่มเป็น 80GB ไม่ได้
เคตตรวจสอบการทำงานโดยเขียนข้อมูลลงในหน่วยความจำที่ใช้งานได้ทั้งหมดแล้วอ่านกลับ เธอยังระบุว่าสามารถเรียกใช้ vLLM และ SGLang ซึ่งเป็นซอฟต์แวร์สำหรับรันโมเดล AI ได้
ความสามารถด้านการคำนวณก็เพิ่มขึ้นเช่นกัน เคตกล่าวว่าการ์ดที่ดัดแปลงใช้งานสตรีมมิงมัลติโพรเซสเซอร์ (SM) ที่ทำงานได้ปกติราว 120–126 หน่วย ขณะที่ A100 รุ่นปกติมี SM ที่เปิดใช้งานอยู่ 108 หน่วย
บทความทางเทคนิคของเคตระบุปริมาณงาน FP16 ของการ์ดที่ดัดแปลงไว้ที่ 85.858 TFLOP/s ในผลลัพธ์ดิบจาก OpenCL และ 85.861 TFLOP/s ในตารางผลลัพธ์ส่วนท้าย ส่วน A100 ทำได้ 72.488 TFLOP/s และ CMP 170HX ที่ดัดแปลงด้วยวิธีซอฟต์แวร์เดิมทำได้ 50.129 TFLOP/s
ส่วนต่างราว 18% ระหว่างการ์ดที่ดัดแปลงกับ A100 จำกัดอยู่เฉพาะผลการทดสอบ FP16 นี้ ตัวเลขดังกล่าวไม่ได้หมายความว่างาน AI ทุกประเภทจะทำงานเร็วขึ้นในสัดส่วนเดียวกัน
เคตยังทดสอบ PCIe 4.0 และการเชื่อมต่อการ์ดสองใบผ่าน NVLink หลังเสริมชิ้นส่วนและปรับการตั้งค่า โดยระบุว่าการ์ดทั้งสองใบที่ทดสอบแสดงหน่วยความจำใบละ 80GB
อย่างไรก็ตาม การทดสอบนี้ไม่ได้ครอบคลุมฟังก์ชันแก้ไขข้อผิดพลาด (ECC) การประมวลผลวิดีโอ หรือการแบ่งส่วน GPU จึงยังไม่มีผลยืนยันว่าฟังก์ชันเหล่านี้ทำงานได้หรือไม่
เคตระบุในบทความทางเทคนิคว่าจะเผยแพร่ผลการศึกษาเพิ่มเติมเกี่ยวกับ NVLink ในบทความต่อไป



Comment 0