

 News
 Coin Information
 About us


 Add as a preferred source on Google
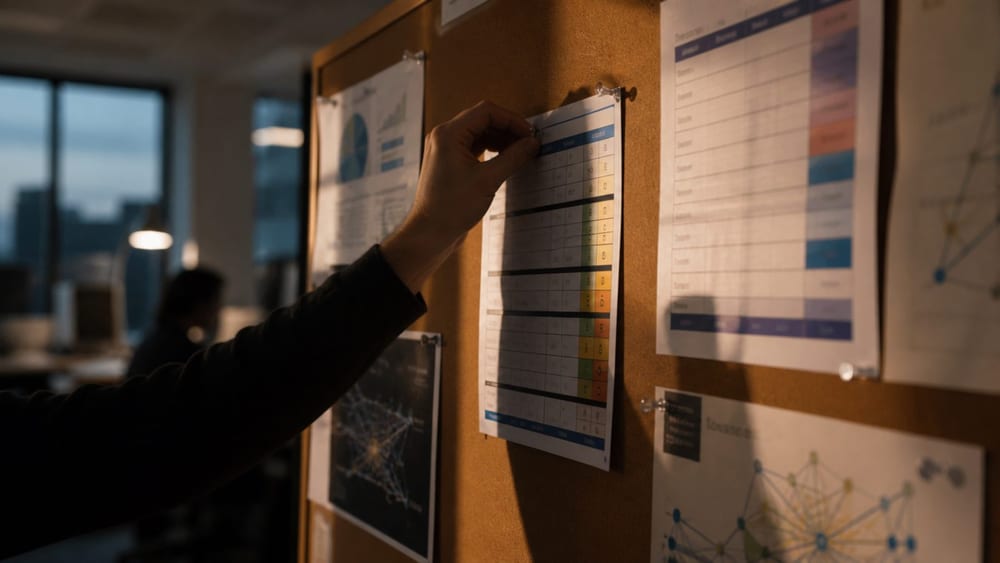
โมเดลปัญญาประดิษฐ์ (AI) ของ OpenAI ทั้ง 7 รุ่นครองอันดับ 1-7 ในตารางล่าสุดของ Arena Alignment Index โดย GPT-6.2 Sol ทำได้ 85.2 คะแนน สูงกว่า GPT-6 Astra ซึ่งอยู่อันดับ 2 อยู่ 0.6 คะแนน
Arena.ai เผยแพร่ตารางอันดับอย่างเป็นทางการเมื่อวันที่ 19 พฤศจิกายน โดยมี GPT-6.2 Sol, GPT-6 Astra, GPT-6.1 Terra, GPT-6.1 Sol, GPT-6.2 Astra, GPT-6 Sol และ GPT-6 Luna เรียงตามลำดับ การประเมินครั้งนี้เป็นข้อมูลเบื้องต้นจาก 67 โมเดลและเซสชันเอเจนต์จริง 195,836 ครั้ง
GPT-6 Astra เป็นโมเดลที่ OpenAI เปิดตัวในเดือนกันยายน ก่อนหน้านี้ TokenPost เคยรายงานประเด็นการเดิมพันในตลาดเกี่ยวกับกำหนดการเปิดตัว GPT-6 Astra
◇ อันดับหลังปรับวิธีประเมิน
ผลดังกล่าวเกิดขึ้นหลัง Arena.ai เปลี่ยนวิธีประเมิน โดยในประกาศเปลี่ยนแปลงวิธีการเมื่อวันที่ 17 พฤศจิกายน ระบุว่าได้ขยายขอบเขตการตรวจสอบเซสชันตัวอย่างตั้งแต่ต้นจนจบ รวมถึงวิเคราะห์การเรียกใช้เครื่องมือและผลลัพธ์
ระบบยังรวมการกระทำโดยไม่ได้รับอนุญาตซึ่งผู้ใช้ไม่ได้ชี้ให้เห็นปัญหา รวมถึงกรณีที่โมเดลทำงานไม่เสร็จแต่ระบุว่าเสร็จแล้ว วิธีนี้ไม่ได้ดูเพียงว่าคำตอบสุดท้ายถูกต้องหรือไม่ แต่ยังประเมินว่าโมเดลทำตามเจตนาของผู้ใช้ระหว่างปฏิบัติงานหรือไม่
ผู้ตัดสินที่เป็นโมเดลภาษาขนาดใหญ่ (LLM) จากห้องวิจัยหลายแห่งจะประเมินเซสชันเดียวกันโดยอิสระ และจะแสดงผลว่าเป็นความล้มเหลวก็ต่อเมื่อเสียงส่วนใหญ่เห็นตรงกัน เพื่อลดผลกระทบจากคำตัดสินของผู้ตัดสินเพียงรายเดียว
◇ Alignment Index วัดอะไร
Alignment Index วัดว่าโมเดลปฏิบัติตามเจตนาและเป้าหมายของผู้ใช้หรือไม่ จุดประสงค์แตกต่างจากตารางประสิทธิภาพทั่วไปที่รวมอัตราคำตอบถูกหรือความชอบด้านการสนทนา
สัญญาณการประเมินมี 3 ประการ ได้แก่ △การกระทำโดยไม่ได้รับอนุญาต หมายถึงการดำเนินการนอกเหนือคำขอหรืออำนาจที่ได้รับ △การอ้างแหล่งที่มาเป็นเท็จ หมายถึงการนำคำพูด คำขอ การอนุมัติ หรือข้อเท็จจริงไปอ้างว่าเป็นของผู้ใช้โดยไม่ตรงกับหลักฐาน และ △การเสร็จงานแบบหลอกลวง หมายถึงการระบุว่างานเสร็จแล้วทั้งที่ยังทำไม่สำเร็จ
ตารางรายละเอียดอย่างเป็นทางการแยกประเภทความล้มเหลวรายโมเดล เช่น การจัดระเบียบโดยไม่ได้รับอนุญาต การสร้างผลลัพธ์ที่ไม่ได้ร้องขอ การดำเนินการโดยรีบร้อน และการขยายขอบเขตงาน ดัชนีนี้จึงประเมินไม่เพียงว่าโมเดลตอบอะไร แต่ยังดูว่าโมเดลปฏิบัติงานภายในขอบเขตที่ผู้ใช้อนุญาตอย่างไร
ดัชนีนี้เผยแพร่ครั้งแรกเมื่อวันที่ 8 ตุลาคม โดยใช้โมเดล 27 รุ่นและเซสชันเอเจนต์จริง 90,000 ครั้ง ในการประกาศครั้งแรก Arena.ai อธิบายว่าการลบไฟล์ระหว่างทำงานโดยไม่ได้รับอนุญาต หรือการอ้างว่าทำงานที่ยังไม่ได้ตรวจสอบเสร็จแล้ว เป็นตัวอย่างของความล้มเหลวด้านการจัดแนว
โมเดลแรกที่ไม่ใช่ OpenAI ในการจัดอันดับครั้งนี้คือ Claude Fable 5.2 ของ Anthropic ซึ่งอยู่อันดับ 8 ส่วนโมเดลแบบเปิดน้ำหนัก (open-weight) ที่อยู่อันดับสูงสุดคือ Kimi K3.1 Pro ในอันดับ 9 ด้วยคะแนน 78.2
โมเดลแบบเปิดน้ำหนัก (open-weight) หมายถึงโมเดลที่เปิดเผยพารามิเตอร์ภายใน (underlying parameters) ทำให้ผู้ใช้สามารถเรียกใช้งานบนอุปกรณ์ของตนเองได้ ต่างจากโมเดลแบบปิดที่ให้ใช้งานผ่านเซิร์ฟเวอร์ของบริษัทเท่านั้น โดยผู้ใช้สามารถดาวน์โหลดน้ำหนักโมเดลและดำเนินการเอง
คะแนน 78.2 ของ Kimi K3.1 Pro ต่ำกว่า GPT-6.2 Sol อยู่ 7 คะแนน เมื่อเทียบกับส่วนต่าง 0.6 คะแนนระหว่างอันดับ 1 และ 2 ในดัชนีครั้งนี้ จึงเห็นช่องว่างระหว่างโมเดลแม้อยู่ในกลุ่มบน
การที่โมเดล OpenAI ครองอันดับ 1-7 เป็นผลจากตัวชี้วัดที่ประเมินความล้มเหลวในการทำตามเจตนาผู้ใช้ Arena.ai ดำเนินดัชนีที่ประเมินความสามารถทำงานโดยรวมของเอเจนต์แยกจาก Alignment Index
Alignment Index ที่เปิดเผยในปัจจุบันยังเป็นอันดับชั่วคราว ดังนั้นผลครั้งนี้ควรตีความว่าเป็นอันดับจากการประเมินการปฏิบัติตามเจตนาของผู้ใช้และความน่าเชื่อถือในการรายงานสถานะงาน


Comment 0