

 News
 Coin Information
 About us


 Add as a preferred source on Google
กูเกิลลดเวลาจัดวางชิปที่พัฒนาเองจากหลายสัปดาห์เหลือไม่กี่ชั่วโมงด้วย Gemini พร้อมเปิดตัวระบบหน่วยประมวลผลเทนเซอร์ (TPU) รุ่นที่ 8 เพิ่มอีก 2 แบบ
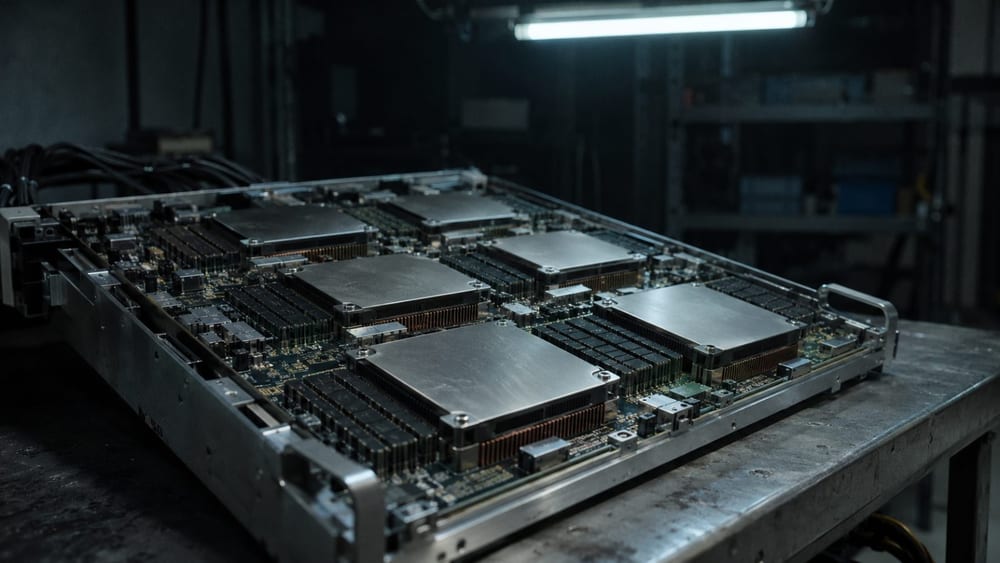
กูเกิล (Google) ระบุในประกาศอย่างเป็นทางการเมื่อวันที่ 10 (เวลาเกาหลี) ว่าได้นำ Gemini และ AlphaChip จาก Google DeepMind มาใช้พัฒนาฮาร์ดแวร์รุ่นถัดไป ระบบใหม่ที่เปิดตัวคือ TPU 8tx และ TPU 8i Max
การจัดวางชิปคือการกำหนดตำแหน่งของทรานซิสเตอร์หลายพันล้านตัวบนแผ่นเวเฟอร์ซิลิคอน เวลาจากหลายสัปดาห์เหลือหลายชั่วโมงที่กูเกิลกล่าวถึงเป็นเวลาสำหรับขั้นตอนนี้ ส่วนการออกแบบชิปใหม่ทั้งชิ้นยังใช้เวลาหลายปี
ผลิตภัณฑ์ทั้งสองเป็นระบบที่ประกอบขึ้นจากชิป TPU ที่มีอยู่แล้ว ไม่ใช่ชิปซิลิคอนรุ่นใหม่ ชิปเป็นเซมิคอนดักเตอร์ที่ทำงานประมวลผล ส่วนระบบประกอบด้วยเครือข่าย อุปกรณ์จัดเก็บข้อมูล และส่วนประกอบอื่น ๆ ที่เชื่อมต่อกับชิป
กูเกิลระบุว่าสามารถปรับหน่วยความจำ เครือข่าย และระบบรักษาความปลอดภัยรอบชิปให้เหมาะกับงานเฉพาะได้ บริษัทกล่าวว่าวิธีนี้ช่วยให้จัดหาระบบเฉพาะทางได้ภายในหลายเดือน แทนที่จะใช้เวลาหลายปี
กูเกิลกล่าวว่าลูกค้าในอุตสาหกรรมที่มีกฎกำกับดูแลเข้มงวดต้องการการคุ้มครองข้อมูล ขณะที่ธุรกิจต้องการโมเดล AI ที่ประมวลผลบริบทได้มากขึ้น TPU 8tx มุ่งเน้นด้านความปลอดภัย ส่วน TPU 8i Max รองรับการประมวลผลบริบทขนาดใหญ่
TPU 8tx เป็นระบบสำหรับการอนุมานแบบรักษาความลับ (confidential inference) เพื่อประมวลผลข้อมูลที่ละเอียดอ่อน โดยใช้ซิลิคอนแบบเดียวกับ TPU 8t และออกแบบให้ปกป้องและแยกข้อมูลกับน้ำหนักโมเดลระหว่างการทำงาน นอกจากนี้ยังรองรับงานฝึกโมเดลขนาดเล็ก
การประมวลผลแบบรักษาความลับมุ่งคุ้มครองข้อมูลขณะที่คอมพิวเตอร์กำลังใช้งาน โดยทั่วไปข้อมูลจะถูกเข้ารหัสขณะจัดเก็บหรือส่งผ่านเครือข่าย แต่ระหว่างประมวลผล ข้อมูลจะถูกปลดล็อกในหน่วยความจำ
กูเกิลนำเสนอ TPU 8tx สำหรับอุตสาหกรรมที่มีกฎกำกับดูแลและหน่วยงานภาครัฐ ซึ่งต้องจัดการทั้งข้อมูลละเอียดอ่อนและโมเดลของตนเอง
TPU 8i Max รวมชิป TPU 8i สองตัวไว้ในแพ็กเกจเดียว กูเกิลระบุว่าเมื่อเทียบกับ TPU 8i แล้ว ระบบใหม่นี้มีสมรรถนะการประมวลผล หน่วยความจำภายในชิป (SRAM) และแบนด์วิดท์ของหน่วยความจำแบนด์วิดท์สูง (HBM) เพิ่มขึ้นเป็น 2 เท่า
การเพิ่มความจุและแบนด์วิดท์ของหน่วยความจำมีเป้าหมายให้โมเดล AI ประมวลผลบริบทได้ยาวขึ้น เช่น เอกสารขนาดใหญ่ โค้ดเบสจำนวนมาก หรือวิดีโอที่มีความยาวหลายชั่วโมง
ในเดือนเมษายน กูเกิลเปิดตัว TPU 8t สำหรับฝึกโมเดลขนาดใหญ่ และ TPU 8i สำหรับการอนุมานแบบเรียลไทม์ ในงาน Google Cloud Next ทั้งสองระบบรวมกับ 8tx และ 8i Max ที่เปิดตัวครั้งนี้เป็นผลิตภัณฑ์ TPU รุ่นที่ 8
ตัวเลขสมรรถนะที่กูเกิลให้ไว้เมื่อเทียบกับรุ่นก่อนคือ TPU 8t มีสมรรถนะการฝึกสูงสุด 2.7 เท่า และ TPU 8i มีสมรรถนะต่อราคาสำหรับการอนุมานดีขึ้น 80% ตัวเลขเหล่านี้ไม่ได้หมายถึงสมรรถนะของ TPU 8tx หรือ TPU 8i Max ที่เพิ่งเปิดตัว
กูเกิลระบุว่านี่เป็นครั้งแรกที่บริษัทเปิดตัวระบบ TPU 4 แบบภายในปีเดียว ก่อนหน้านี้ TokenPost รายงานว่ากูเกิลเปิดตัวระบบ TPU สองแบบที่มุ่งรองรับการอนุมานแบบรักษาความลับและการประมวลผลบริบทระยะยาว
ลูกค้าสามารถใช้ TPU เพื่อฝึกโมเดลภายในกูเกิล ผ่าน Google Cloud หรือในศูนย์ข้อมูลที่ลูกค้าดำเนินงานเองได้ กูเกิลระบุว่ามีลูกค้า TPU ราว 100 ราย ซึ่งรวมถึงสถาบันวิจัย บริษัทด้านการเทรด ผู้ค้าปลีก และมหาวิทยาลัย

Comment 0