

 News
 Coin Information
 About us


 Add as a preferred source on Google
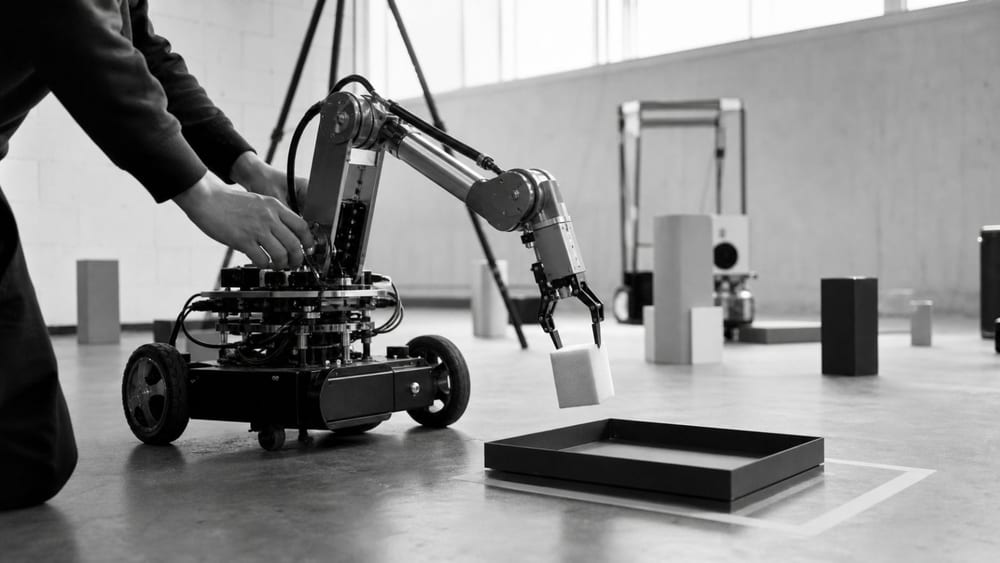
ไดนา โรโบติกส์ (Dyna Robotics) เปิดตัว Dyna-2.1 เมื่อวันที่ 29 กันยายน โดยแยกการวางแผนงานระยะยาวออกจากการสั่งให้หุ่นยนต์ลงมือทำ ระบบประกอบด้วยโมเดลภาพและภาษาเพื่อประสานงาน นโยบาย Dyna-2 และตัวควบคุมทั้งร่างกายอีกชุดหนึ่ง
บริษัทอธิบายในเอกสารทางเทคนิค Dyna-2.1ว่า โมเดลประสานงานจะกำหนดขั้นตอนถัดไป นโยบาย Dyna-2 จะสร้างเส้นทางการเคลื่อนไหวเป้าหมาย ส่วนตัวควบคุมทั้งร่างกายจะควบคุมค่าเป้าหมายของข้อต่อและความเร็วล้อ 100 ครั้งต่อวินาที
โมเดลประสานงานบันทึกสถานะงานเป็นข้อความ เช่น เครื่องซักผ้าทำงานแล้วหรือยัง และพับผ้าเช็ดตัวไปกี่ผืน จากนั้นใช้บันทึกประกอบการตัดสินใจครั้งถัดไป หน่วยความจำนี้ช่วยให้ระบบทำงานต่อเนื่องจากความคืบหน้าก่อนหน้า แต่การเพิ่มบันทึกเพียงอย่างเดียวไม่ได้หมายความว่านโยบายการเคลื่อนไหวเรียนรู้ทักษะใหม่
กูเกิล ดีปมายด์ (Google DeepMind) เปิดตัว Gemini Robotics 2, Gemini Robotics ER 2 และ Gemini Robotics On-Device 2 เมื่อวันที่ 30 กรกฎาคม ตามโครงสร้างที่บริษัทเปิดเผย โมเดลภาพ ภาษา และการกระทำ (VLA) แปลงข้อมูลนำเข้าเป็นคำสั่งควบคุมการเคลื่อนไหว โมเดลให้เหตุผลทำความเข้าใจสภาพแวดล้อมทางกายภาพและวางแผนงานหลายขั้นตอน ส่วนโมเดล On-Device ทำงานบนอุปกรณ์หุ่นยนต์ (ประกาศ)
เฮลิกซ์ (Helix) ของฟิกเกอร์ AI (Figure AI) แบ่งรอบการทำงานออกเป็นสองระดับ บริษัทระบุในประกาศ Helixว่า โมเดลภาพและภาษาที่เข้าใจฉากกับคำสั่งทำงาน 7–9 ครั้งต่อวินาที ขณะที่นโยบายการเคลื่อนไหวจากการมองเห็นซึ่งสร้างการเคลื่อนไหวต่อเนื่องทำงาน 200 ครั้งต่อวินาที
รอบการทำงานของ Helix เป็นค่าที่กำหนดไว้ในการออกแบบระบบ ไม่ใช่ตัวชี้วัดมาตรฐานที่นำไปเปรียบเทียบโดยตรงกับอัตราการตอบสนองในการประเมินของ Anthropic หรือสมรรถนะของระบบหุ่นยนต์อื่นได้
งานวิจัยบางส่วนรวมความรู้ด้านภาษาและการมองเห็นเข้ากับการสร้างการเคลื่อนไหวในโมเดลตระกูลเดียวกันด้วย Google DeepMind เปิดตัว RT-2 ในปี 2023 โดยนำข้อมูลสาธิตการทำงานของหุ่นยนต์มาผสานกับโมเดลภาพและภาษาที่ฝึกล่วงหน้าด้วยข้อมูลระดับเว็บ บริษัทระบุว่า ในการทดสอบหุ่นยนต์กว่า 6,000 ครั้ง ความสามารถในการทำงานใหม่ที่ไม่เคยพบมาก่อนดีขึ้นมากกว่า 3 เท่าเมื่อเทียบกับโมเดลพื้นฐานเดิม (ประกาศ RT-2)
Dyna Robotics ระบุว่าได้ฝึก Dyna-2 ล่วงหน้าด้วยวิดีโอจากมุมมองบุคคลที่หนึ่งซึ่งถ่ายโดยมนุษย์รวมกว่า 1 ล้านชั่วโมง งานวิจัยที่บริษัทนำเสนอพบว่า เมื่อเพิ่มข้อมูลวิดีโอของมนุษย์ ประสิทธิภาพการทำนายจากข้อมูลหุ่นยนต์ที่ประเมินแยกต่างหากก็ดีขึ้นตามไปด้วย
ตัวเลข 1 ล้านชั่วโมงหมายถึงความยาวของวิดีโอที่มนุษย์ถ่าย ไม่ได้หมายถึงเวลาที่หุ่นยนต์เคลื่อนไหวจริงหรือขนาดของชุดข้อมูลสาธิตการทำงานของหุ่นยนต์
ก่อนถามว่าโมเดลภาษาขนาดใหญ่ (LLM) จะมาแทนโมเดลหุ่นยนต์หรือไม่ จึงควรแยกให้ชัดว่าหมายถึงโมเดลประเภทใด ตัวอย่างที่เปิดเผยมีทั้งโมเดลวางแผนงาน นโยบายสร้างการเคลื่อนไหว และชั้นควบคุมระดับต่ำ ขณะที่งานวิจัยบางส่วนรวมความรู้กับการสร้างผลลัพธ์การกระทำไว้ในโมเดลตระกูลเดียวกัน
ความเร็วตอบสนองสำหรับการควบคุมระดับต่ำยังเป็นโจทย์แยกต่างหาก Anthropic ระบุในการประเมินการควบคุมหุ่นยนต์เมื่อเดือนกรกฎาคมว่า การควบคุมระดับต่ำของหุ่นยนต์สี่ขาต้องใช้การตอบสนองราว 83 ครั้งต่อวินาที แต่โมเดลที่ไม่ใช้การให้เหตุผลในขณะนั้นตอบสนองราว 0.2–0.4 ครั้งต่อวินาที
การทดสอบควบคุมโดยตรงใช้วิธีหยุดตัวจำลองระหว่างรอคำตอบจากโมเดล ผลนี้จึงไม่ควรตีความว่าเป็นการวัดสมรรถนะการควบคุมหุ่นยนต์จริงแบบเรียลไทม์ หรือขยายเป็นข้อสรุปเกี่ยวกับความสามารถในการควบคุมของ LLM ทุกโมเดล
ในการประเมินเดียวกัน Anthropic ยังรายงานกรณีที่โมเดลภาษาใช้กำกับนโยบายหุ่นยนต์ที่ฝึกไว้ล่วงหน้า แล้วทำงานเคลื่อนที่และจัดการวัตถุบางอย่างได้ การทดสอบที่โมเดลควบคุมข้อต่อโดยตรงกับการทดสอบที่โมเดลกำกับนโยบายเดิมมีเงื่อนไขต่างกัน
การเก็บข้อมูลเพื่อถ่ายทอดการสาธิตของมนุษย์ไปยังนโยบายหุ่นยนต์ก็อยู่ระหว่างการศึกษา งานวิจัย UMI พิจารณาความแตกต่างทางร่างกายระหว่างมนุษย์กับหุ่นยนต์ ความแม่นยำของการเคลื่อนไหว และความล่าช้าในการอนุมานในฐานะโจทย์ด้านการออกแบบ (งานวิจัย)
การทำฉากจำลองให้ดูสมจริงขึ้นกับการทำนายผลทางกายภาพในโลกจริงให้แม่นยำเป็นคนละประเด็น งานวิจัยด้านการจำลองหุ่นยนต์ชิ้นหนึ่งรายงานว่า แม้เพิ่มความเที่ยงตรงในบางภารกิจนำทางด้วยภาพ ก็ไม่ได้ช่วยให้ถ่ายโอนผลไปสู่สภาพแวดล้อมจริงได้ดีขึ้นเสมอไป ขณะที่ตัวจำลองที่ทำงานช้าและการปรับเข้ากับข้อผิดพลาดของแบบจำลองทางฟิสิกส์มากเกินไปอาจลดสมรรถนะได้ (งานวิจัย) ผลดังกล่าวมาจากภารกิจที่ทีมวิจัยศึกษา จึงไม่อาจสรุปครอบคลุมตัวจำลองทุกประเภทได้
ก่อนหน้านี้ TokenPost รายงานกรณี PeakOS ซึ่งผสาน World ID และเผยแพร่การสาธิตหุ่นยนต์ส่งยา (รายงานก่อนหน้า)
Dyna Robotics ระบุว่าขั้นต่อไปคือการนำ Dyna-2.1 ไปใช้งานในสถานที่ของลูกค้า ตัวอย่างที่เปิดเผยแสดงให้เห็นแนวทางการออกแบบที่แยกหรือผสานการวางแผน การสร้างการเคลื่อนไหว และการควบคุมระดับต่ำ

Comment 0