

 ข่าว
 ข้อมูลเหรียญ
 แนะนำสื่อ


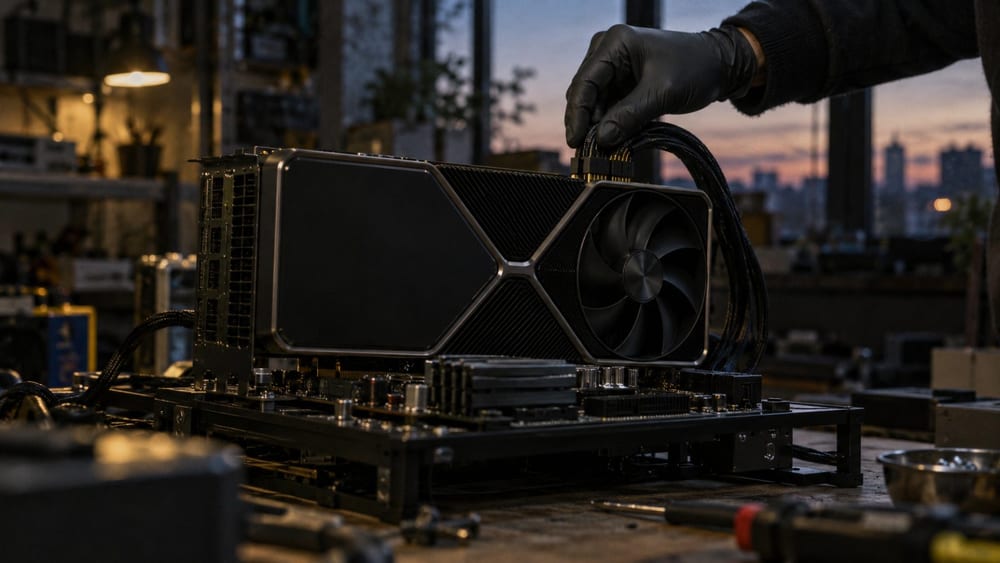
การทดสอบพบว่าการ์ดจอ RTX 3090 Ti ของ NVIDIA($NVDA) ที่ใช้เครื่องมือโอเพนซอร์ส gpu-unlock ทำงานเมทริกซ์แบบ BF16 ได้เพิ่มจาก 87.50 TFLOPS เป็น 157.41 TFLOPS หรือเพิ่มขึ้นราว 80% อย่างไรก็ตาม ผลทดสอบการคำนวณเฉพาะรายการนี้ไม่ได้หมายความว่าความเร็วโดยรวมของโมเดล AI จะเพิ่มขึ้นในสัดส่วนเดียวกัน
นักพัฒนา Zagitta ระบุในเอกสารโครงการว่า โมดูลเคอร์เนล Linux เปลี่ยนการตั้งค่าความเร็วการคำนวณก่อนที่ไดรเวอร์ NVIDIA จะเชื่อมต่อกับการ์ดจอ วิธีนี้ไม่ได้เขียน vBIOS ใหม่หรือแก้ไขไดรเวอร์ เครื่องมือรองรับ GPU สถาปัตยกรรม Ampere ซึ่งใช้ใน RTX 30 Series
การทดสอบ RTX 3090 Ti ที่โครงการเผยแพร่กำหนดขีดจำกัดการใช้พลังงานไว้ที่ 450W และวัดการคูณเมทริกซ์ขนาดใหญ่ 5 ครั้ง ก่อนนำค่ามัธยฐานมาเปรียบเทียบ ภายใต้เงื่อนไขเดียวกัน ประสิทธิภาพ TF32 เพิ่มจาก 42.58 TFLOPS เป็น 82.61 TFLOPS ส่วน FP16 เพิ่มจาก 87.46 TFLOPS เป็น 118.39 TFLOPS BF16 เป็นรูปแบบตัวเลขที่ใช้ในการประมวลผล AI ขณะที่ TFLOPS ใช้ระบุจำนวนการคำนวณต่อวินาที
Zagitta ระบุในเอกสารโครงการว่า ผลทดสอบจากผู้ใช้พบว่าความเร็วขั้นตอน prefill ของโมเดลภาษาขนาดใหญ่ดีขึ้น 14–36% โดย prefill คือขั้นตอนประมวลผลข้อมูลนำเข้าก่อนโมเดลสร้างคำตอบ ส่วนขั้นตอน decode ซึ่งสร้างคำตอบทีละโทเคนและงาน INT8 โดยทั่วไปมีความเร็วใกล้เคียงเดิม
ผลการรองรับแตกต่างกันไปตามรุ่นการ์ดจอ รายงานจากผู้ใช้ในโครงการมีกรณีที่ประสิทธิภาพดีขึ้นบน RTX 3090 Ti, RTX 3090, RTX 3080, RTX 3070 และ RTX 3060 12GB อย่างไรก็ตาม การ์ด RTX 3080 Ti 20GB รุ่น OEM บางรุ่นยังมีประสิทธิภาพ BF16 อยู่ที่ราวครึ่งหนึ่ง แม้เครื่องมือจะทำงานแล้วก็ตาม
โครงการระบุว่าเงื่อนไขการทดสอบของการ์ดแต่ละรุ่นแตกต่างกัน จึงเปรียบเทียบระดับการปรับปรุงโดยตรงได้ยาก อีกทั้งขีดจำกัดการใช้พลังงานยังส่งผลต่อผลลัพธ์อย่างมาก ดังนั้นอัตราเพิ่มขึ้นราว 80% จากการทดสอบนี้จึงไม่อาจนำไปสรุปเป็นอัตราเพิ่มความเร็วของบริการ AI จริงหรือการ์ดจอทุกรุ่นได้


ความคิดเห็น 0